【フィジカルAI入門①】スマホの中のAIが「手足」を手に入れた? 今話題の「フィジカルAI」って何だろう

最近ニュースでよく見る「フィジカルAI」って言葉。難しそうに聞こえるけど、実はすっごくシンプルなの。ひとことで言うと「画面の中にいたAIが、現実世界で動くための“体”を手に入れた姿」のこと。今日はこれまでのロボットと何が違うのか、AI初心者さんにもわかるようにゆる〜く解説していくね!
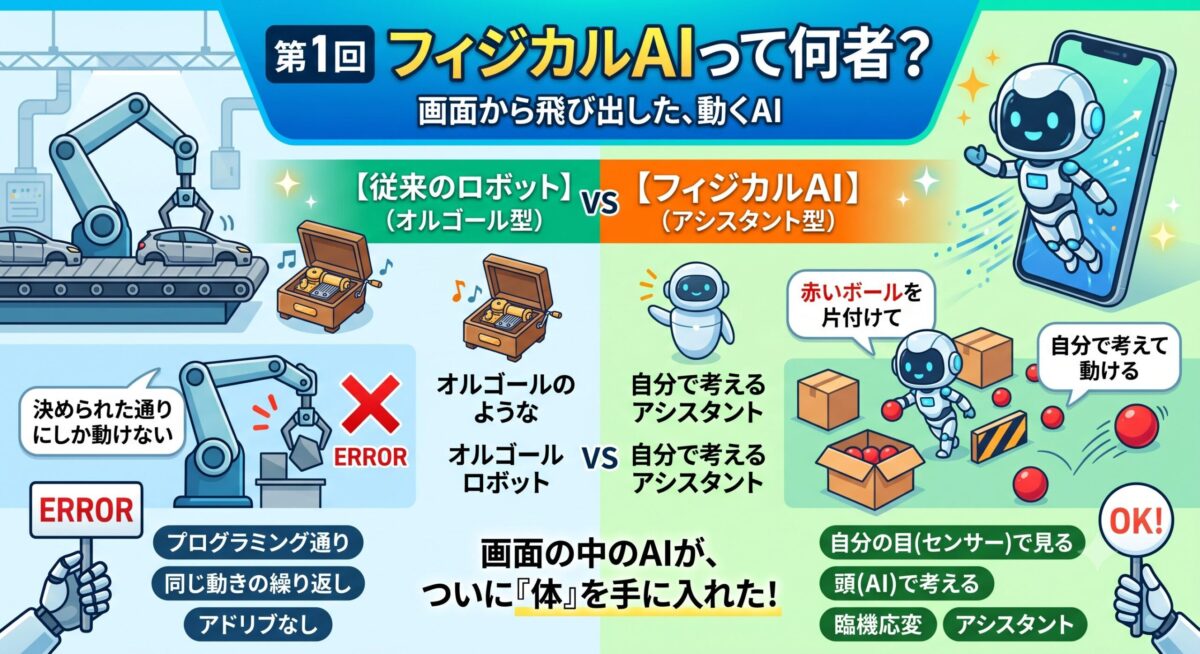
従来のロボットは「超優秀なオルゴール」
「ロボットなら昔から工場やレストランで動いてるよね?」——確かに、車を作る巨大なアームや、決められたルートを走る配膳ロボットはもう活躍しているよね。これまでのロボットが得意だったのは「決められた通りに、同じ動きを正確に繰り返すこと」。
たとえるなら、ゼンマイを巻くと決まった曲を寸分たがわず演奏する「オルゴール」みたいなもの。プログラム通りに動くのは大得意だけど、目の前に突然モノが置かれたり、部品の形がいつもと違ったりすると「どうすればいいかわからない!」とパニックになって、エラーで止まってしまうんだ。
フィジカルAIは「臨機応変に動けるアシスタント」
一方、最新のフィジカルAIには決定的な違いがあるの。それが「自分の目(センサー)で見て、頭(AI)で考えて、臨機応変に動く」ことができる点。たとえば「赤いボールを箱に片付けて」とお願いしたとするね。
- 従来のロボット:「右に30センチ進んで、アームを10センチ下げて掴む」という厳密な指示がないと動けない。ボールが少しズレただけで失敗しちゃう。
- フィジカルAI:自分でカメラを使ってボールを探し、「あそこにあるな」と判断して、障害物をよけながら自力で取りに行く。転がって逃げても、追いかけて掴める。
つまり、人間が細かい動きをいちいち指示しなくても、言葉で「目的」を伝えるだけで、自分でやり方を考えて実行してくれるんだ。

補足:この「言葉で目的を伝えるだけで動く」仕組みの背景には、Google DeepMindが2023年に発表した「RT-2」に代表される VLA(Vision-Language-Action)モデル がある。視覚と言語をまとめて理解し、直接“行動”を出力するのが特徴だ。
なぜ今、急に進化しているの?
「そんなすごいロボット、なんで今まで無かったの?」って思うよね。実はコンピューターにとって「現実世界」はあまりに複雑すぎるという問題があったの。光の反射、床のすべりやすさ、物の重さや柔らかさ……現実には、画面の中のデータと違って計算通りにいかない「予想外」があふれているんだ。
でも近年、AIの「頭脳」が爆発的に賢くなった。おかげで現実の複雑な状況を一瞬で理解して「今どう動くべきか」を計算できるように。さらに、コンピューターの中の「仮想空間」でロボットに何百万回も失敗と成功を繰り返させる猛特訓の技術が進んだことで、現実世界でもスムーズに動けるようになったんだ。
補足:仮想空間での“猛特訓”は、専門的には強化学習とシミュレーションの組み合わせ。うまくできたら報酬を与えて何度も繰り返し、現実世界に出る準備をする。危険もコストもゼロで練習できるのが強みだ。
今日のまとめ
- フィジカルAI=画面の中のAIが「体」を持って現実世界で動くようになった姿
- 従来のロボットは「決まった動きの繰り返し」が得意な“オルゴール型”
- フィジカルAIは「見て・考えて・臨機応変に動く」=目的を伝えるだけで自分で実行
- AIの頭脳の進化と、仮想空間での猛特訓の技術が、この進化を後押ししている
画面の中で文章を書いていたAIが、ついに手足を持って飛び出してきた……これがフィジカルAIの正体なんだ。次回は「家事も介護も手伝ってくれる? 私たちの暮らしを変えるフィジカルAIの未来」をのぞいてみるよ。お楽しみに!
参考情報
- NVIDIA「フィジカル AI とは?」(公式グロッサリー)
- Google DeepMind「RT-2: New model translates vision and language into action」
この記事はShin’s AI Collabの「フィジカルAI入門」シリーズ第1回です。



コメント